解码未来 多模态AI与可穿戴设备的深度融合里程碑
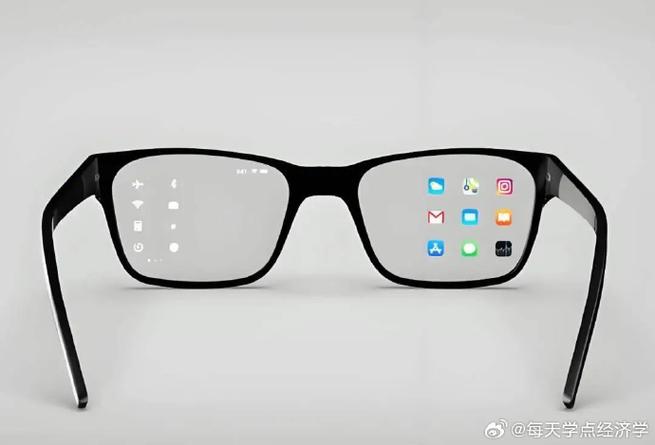
在科技迅猛发展的今天,多模态人工智能与可穿戴设备的结合正以前所未有的方式重塑人类与数字世界的交互范式。这款产品的问世,正是这一融合趋势下的重要落地成果,标志着智能设备从单一功能、被动响应,迈向了多维感知、主动理解的新纪元。
长期以来,可穿戴设备主要依赖单一模态的数据输入,例如通过加速度计记录步数或利用光学传感器监测心率。这些数据虽然客观,却难以捕捉用户所处的复杂情境与真实意图。而多模态AI的引入,彻底改变了这一局面。通过同时处理视觉、语音、生理信号、运动姿态等多种模态信息,设备能够构建出关于用户状态与环境的高维理解。例如,当用户抬腕时,设备不仅能识别动作,还能结合语音语调、心率变异性与光线环境,判断其是在准备晨跑还是处于紧张会议中,从而提供截然不同的反馈。
这一里程碑式的落地成果,首先体现在智能设备的“感知升维”。传统设备依赖触控与预设指令,而多模态系统可以融合麦克风阵列、惯性测量单元、生物传感器与微型摄像头的数据流,在边缘端进行实时融合推理。这意味着设备能在不依赖云端的情况下,理解手势、表情、语音情绪甚至微弱的手指微动。交互方式发生了根本性转变:用户不再需要主动唤醒或说出特定命令,设备通过持续分析多模态线索,即可预判需求——比如在用户感到焦虑时自动播放舒缓音乐,或在运动强度过高时震动提醒。这种从“指令驱动”到“意图驱动”的跨越,显著降低了交互门槛,让科技真正隐于无形。
更重要的是,这款产品为智能设备赋予了情境智能与个性化适应能力。面对不同用户、不同场景,多模态模型可以在本地持续学习,动态调整模型权重。一位老人佩戴时注重跌倒检测与心率异常预警,而一位运动员使用时则聚焦于动作矫正与体能分配。同一设备,却能通过多模态融合理解差异化角色,这种适应性正是智能设备向“共生伙伴”演进的关键。
这一成果也带来了新的挑战,如多模态数据隐私、算力功耗平衡以及模型可解释性。但正如历史上每一次计算范式的迁移,问题与突破总是相伴而生。这款产品不仅证明了技术可行性,更打开了可穿戴设备的新想象空间:未来设备或许能结合皮肤电导、血氧与眼动追踪,实现情绪感知与认知负荷监测,成为人类身心健康的第一道防线。
这款产品作为多模态AI与可穿戴设备深度融合的代表作,已然为智能设备的发展树起一座醒目的里程碑。它标志着一个全新阶段的开启:智能设备不再是被动工具,而是能够看、听、感、知,并主动服务于人的延伸伙伴。这场变革才刚刚拉开帷幕。
如若转载,请注明出处:http://www.vicorgi.com/product/2.html
更新时间:2026-10-18 21:26:38